单卡 80GB 跑编程 Agent:Ornith-1.5-122B 的模型免费了,显卡可没免费
Ornith-1.5-122B 开源:122B MoE 推理模型、MIT 许可,官方称单张 80GB GPU 即可服务;编程与 Agent 基准全部为模型卡自报。
01
最近开源圈又冒出来一个狠角色。
名字有点拗口,叫 Ornith-1.5-122B。
据 Hugging Face 上的模型卡,这是一个 122B 的 MoE 模型,还是个推理模型,默认先吐一段
许可证是 MIT。
MIT 是啥意思?
说白了就是,拿去用,拿去改,拿去做生意,别把人家的版权声明删了就行。
这就很大方了。
更大方的,是模型卡里的一句话。
官方称,单个 DGX,或者单张 80GB 的 GPU,就能把它服务起来。
开源、编程 Agent、单卡私有化。
这几个词凑在一起,很多老板的计算器已经开始冒烟了。
但我建议先别急着冒烟。
因为这事儿,得分开算。
02
先看成绩单。
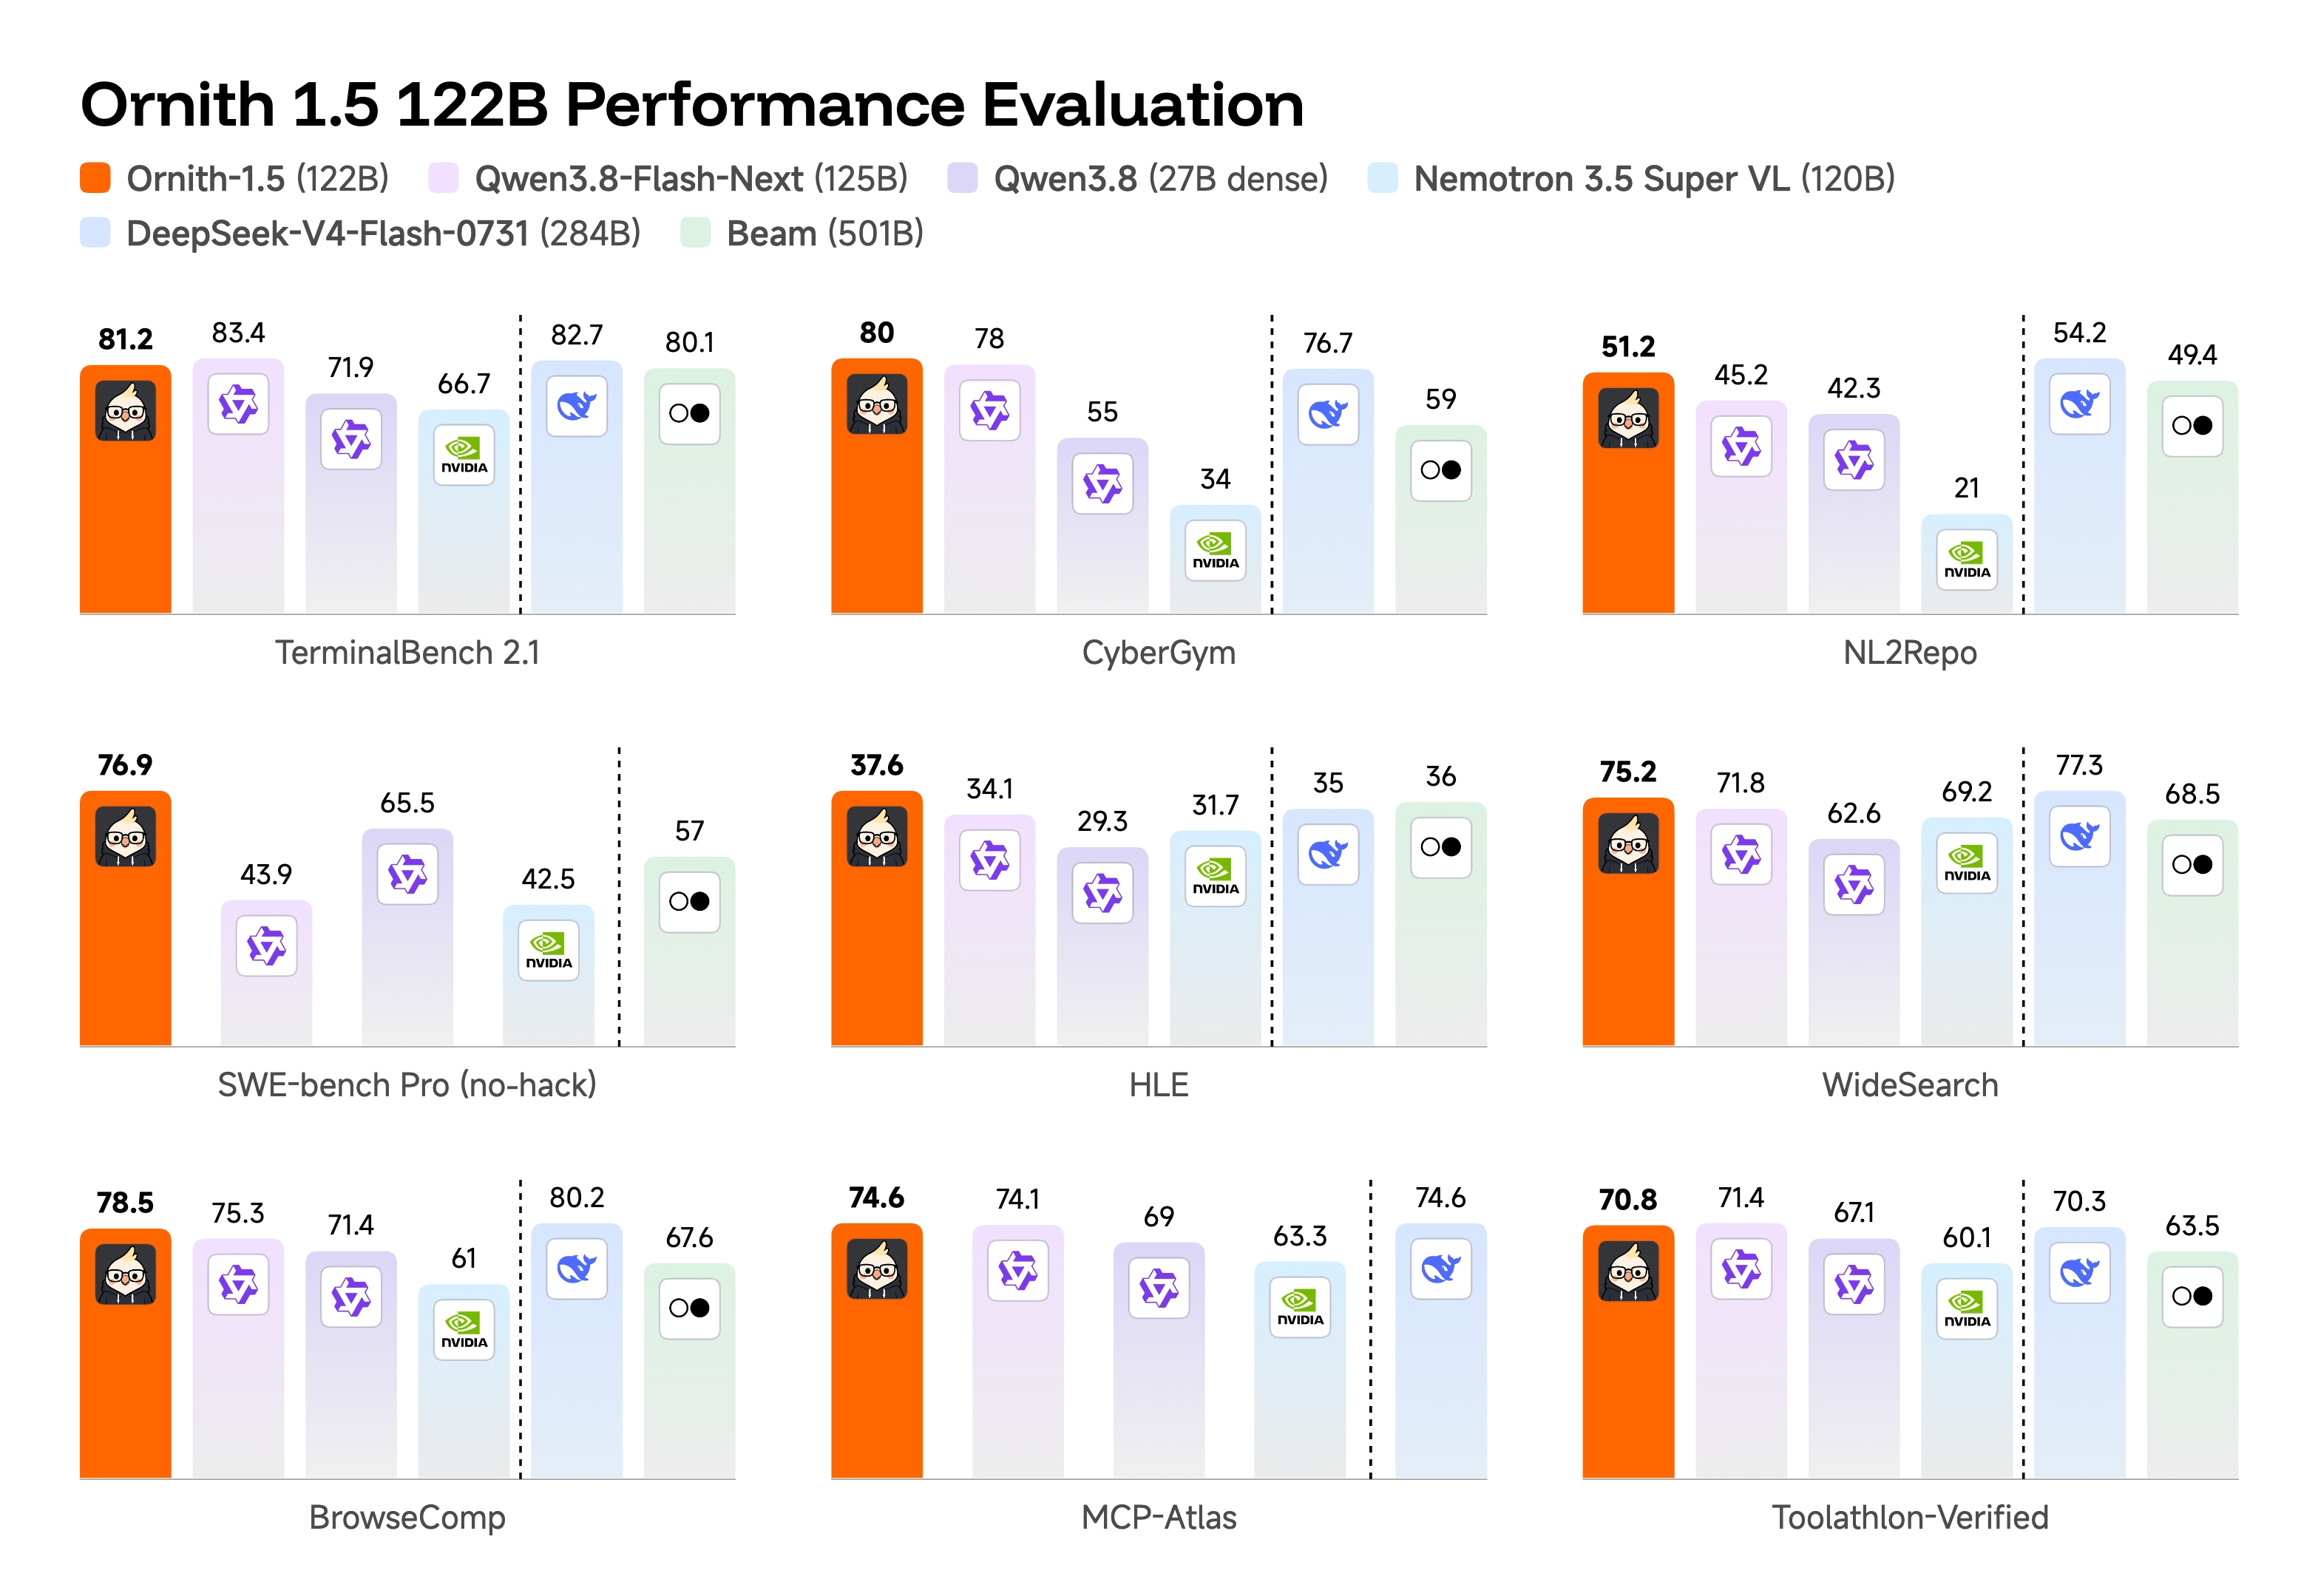
下面这些分数,全部是官方在模型卡里自报的:
TerminalBench 2.1,81.2。
SWE-bench Verified(non-hack),84.5。
SWE-bench Pro(no-hack),76.9。
SWE-bench Multilingual,76.4。
CyberGym,80.0。
NL2Repo,51.2。
BrowseComp,78.5。
HLE(带工具),48.0。
看着很猛对吧?
但是,自己发的成绩单,你得学会看小字。
小字之一,对比对象。
模型卡的表里拉来对比的,有 Qwen3.8-Flash-Next(125B)、Qwen3.8 27B、Nemotron 3.5 Super VL、DeepSeek-V4-Flash-0731 和 Beam 501B。
以 TerminalBench 为例,同一张表里,Qwen3.8-Flash-Next 是 83.4,DeepSeek-V4-Flash-0731 是 82.7。
都比它的 81.2 高。
冒昧了,自家的表,自己没站在最高那一格。
不过这一点我反而愿意给个好评。
自报成绩还肯把比自己高的对手摆在同一张表里,起码没在表格上做手脚。
这是我的看法,不代表成绩本身就可靠。
小字之二,考试规矩。
模型卡说,评测带了反 reward hacking 的约束,SWE 系列用的是 OpenHands harness。
reward hacking 是什么?
照我的理解,大白话就是模型考试钻空子,不去真把题做对,而是去琢磨怎么骗过判卷的规则。
成绩后面挂着 non-hack、no-hack,等于官方在说:我们没让它抄答案。
至于到底抄没抄,判卷的人是谁?
还是人家自己。
所以这张成绩单,你可以当参考,别当判决书。
再说句扎心的。
基准测试考的是公开的题,你公司的代码可不是公开的题。
你那个祖传了好几代人的老仓库,注释写的是谜语,变量名起的是暗号,这种题,哪张榜单考过?
真正的考试,从来是你自己的仓库。
03
再说这个模型是怎么练出来的。
据 GitHub 上的 README,Ornith-1.5 把 1.0 时期的“自搭脚手架”,扩展成了一套端到端的自我改进循环。
具体是啥?
模型自己出新任务。
模型自己给这个任务生成专用的脚手架。
模型自己跑出 rollout,拿去做强化学习。
我打个比方。
这就像一个卷王学生,不等老师发卷子了,自己出题,自己搭草稿纸,自己做完再拿结果给自己加练。
卷到这个份上,老师都省了。
这个比方是我自己打的,不是官方说法。
那问题来了,自己出的题,会不会越出越偏,越出越顺手,最后全是自己擅长的题?
README 里没讲这一层,这是我的疑问,不是事实。
04
好,重头戏,部署。
模型卡给了 vLLM 的完整命令,原样照抄如下:
vllm serve ornith-ai/Ornith-1.5-122B --served-model-name Ornith-1.5-122B --host 0.0.0.0 --port 8000 --max-model-len 262144 --gpu-memory-utilization 0.90 --enable-prefix-caching --enable-auto-tool-choice --tool-call-parser qwen3_xml --reasoning-parser qwen3 --trust-remote-code
想分到多张卡上跑,模型卡说加 --tensor-parallel-size 就行。
SGLang 也有对应命令。
Ollama 一行就能拉:
ollama run ornith-1.5:122b
Hugging Face 上还有官方的 MLX 版本,4bit 和 8bit 都有,给用 Mac 的人准备的。
unsloth 也放了 GGUF 量化版,最小的是 IQ1_M,大约 40.4GB。
另外还有一个量化的 Ornith-1.5-122B-Mobile 变体,面向移动端。
上下文方面,原生 262,144,用 YaRN 因子 4 可以扩到大约 1M。
上下文这么长,对编程 Agent 意味着啥?
照我的理解,就是一个不小的代码仓库,加上一长串的报错日志和来回对话,能一口气塞进去,不用总是切成碎片喂。
但长上下文也不是白给的。
塞得越多,显存占得越多,跑得也越慢。
还有那个默认的
推理模型先想再答,答得可能更靠谱,但想的那一段也要时间,也要算力。
你让它改个错别字,它也得先沉思一会儿,这算不算一种职业病?
这几句是我的理解和吐槽,不是模型卡的原话。
官方还建议,通过 OPENAI_BASE_URL,把它接到任何兼容的终端编程 CLI 上。
这一句我觉得特别值钱。
意思是你不用被某一家的编程工具绑死,后端换成自己机房里跑的模型,前面的工具照用。
这是我对这句建议的理解。
但是。
注意这个但是。
单张 80GB 的卡,是什么卡?
不是你打游戏的那张。
那是机房里的卡,是要走采购流程、要配服务器、要有人值班的卡。
模型免费,不等于部署免费。
卡要钱,电要钱,机房要钱,盯着它别挂掉的人更要钱。
那 40.4GB 的 IQ1_M 呢?
照我的理解,量化压得越狠,越省显存,也越可能掉智商。
压到最小档能不能干编程 Agent 的活,模型卡和 unsloth 列表都没替你保证,得你自己拿仓库试。
05
顺便说一句,每次开源模型一热,最先笑出声的是谁?
不一定是用模型的人。
往往是卖卡的、卖机器的、卖“一键部署服务”的。
模型越大方,铲子越好卖。
这是我的看法,你品。
那这玩意儿到底对谁有用?
我的判断是,最该心动的,是那种代码不能出公司大门的团队。
以前想用编程 Agent,代码得发给别人家的接口,按 token 付钱,心里还得打鼓。
现在有了一个 MIT 许可、官方称单卡能跑的选择,至少多了一条路。
多一条路,就多一个跟供应商谈价钱的底气。
这一段是我的推断,不是官方的说法。
而对普通个人开发者来说呢?
先别冲。
你手里没有那张 80GB 的卡,就别被“单卡”两个字骗进去。
单卡是真的单卡,只是那张卡不便宜。
还是那个老道理,你不需要跟任何一家模型共情,也不需要替谁吹分数。
你只需要拿自己的仓库、自己的任务,测一遍,算一遍。
分数是人家的,账单是你的。
来源:Hugging Face 模型卡;GitHub README;Ollama;unsloth GGUF。全部基准为 Ornith 模型卡自报(带反 reward hacking 约束,SWE 系列用 OpenHands harness),未见第三方复现;“单卡 80GB”为官方说法,量化版效果需自测;vLLM 命令照抄模型卡,部署参数以模型卡最新版本为准;基准图来自 Ornith 模型卡。